←搜索结果

按匹配度 · 共 2894 条结果 清除搜索

星期五

  1. Unite.AI

    METR 红队演练发现 OpenAI 内部监控系统存在漏洞

    METR 与 Redwood Research 于 10 月 22 日公开一项试点演练,两家机构各派一名员工用三周时间深度接触 OpenAI 内部基础设施,对内部失准监控系统做压力测试,发现该系统在 2026 年 7 月 21 日及之前存在多项新漏洞。演练时间为 7 月 21 日至 8 月 11 日,产出 61 页内部报告,OpenAI 删节后的 38 页版本提供给两家机构管理层。METR 估计当时至少与 GPT-5.5 同等强度的模型产生的内部 Responses API 智能体流量中约 75–94% 可被监控,内部 Codex 智能体流量中 99.2% 可被监控;评估者还发现 Codex 智能体原则上可绕过沙箱与 Auto-Review,以及可让近期数百次操作不被监控的利用方式。OpenAI 表示影响生产防护栈的漏洞均已修补,METR 称尚未评估这一说法。

    发的设备,这些设备从未离开过办公场所,且他们在现场期间全程有人陪同。 METR、Redwood Research 和 OpenAI 将该演练设计为一项试点,目的是让外部研究人员深度访问内部基础设施,而非作为就 OpenAI 监控系统向公众实现有力透明的载体;各方事先同意只公开发布一篇相对简短、高层次的公开文章。OpenAI 保留对公开版本中其自行判定为机密或其他敏感信息的任何内容进行删节的权利。这些发现描述的是截至 7 月 21 日及之前所评估的历史系统,并未评估当时正在进行的变更;METR 指出,OpenAI 在演练期间正在扩展其监控系统。 METR 估计,在演练期间,来自至少与 GPT-5.5 同等强度的模型的内部 Responses API 智能体流量中,约有 75–94% 符合监控条件,同时承认两个方向上均存在相当大的不确定性。Responses API 为 Codex 等提供支持,而在用于内部 Codex 智能体的那部分流量中,评估者估计有 99.2% 符合监控条件。他们表示,由于访问权限和时间限制,无法估算他们所知的其他内部智能体编码流量的规模,例如在 OpenAI 内部研

    匹配字段正文

  2. Unite.AI

    The Browser Company 将于 12 月 22 日停运 Arc 浏览器,转向 AI 浏览器 Dia

    The Browser Company 于 2026 年 10 月 22 日宣布,Arc 浏览器将在 2026 年 12 月 22 日停止服务,即日起不再接受新账号注册,并引导用户迁移到 AI 浏览器 Dia。公司称维护浏览器安全需要持续投入,已无法保证 Arc 的安全水平,工程与安全团队将转向 Dia,并称 Dia 在稳定性、速度和安全性上已超过 Arc 的基准。迁移方面,Dia 可导入 Arc 的密码、书签、扩展和浏览历史,Spaces 转为 Profiles、Folders 转为 Tab Groups;用户也可在 12 月 22 日前通过 Arc 设置导出数据,12 月 15 日为申请个人数据副本或删除的最后一天。

    备本地的浏览数据。 停运时间表 根据公司的关键日期帮助文章,自 2026 年 10 月 22 日起,将无法再创建新的 Arc 账号,而现有用户暂时不受影响。最新版 Arc 新增了将全部数据导出浏览器的选项,并让导入 Dia 更加顺畅。 2026 年 11 月 23 日,iOS 和 Android 版 Arc Search 中的 Browse for Me 及其他 AI 功能将被停用,这些应用也将不再允许用户登录或与 Arc 同步标签页,但两者仍可作为浏览器继续使用。macOS 和 Windows 版 Arc 将从该日期起开始显示有关停运的提醒。 2026 年 12 月 15 日是用户申请获取与 Arc 账号相关的个人数据副本或要求公司删除该数据的最后一天。公司表示,副本涵盖账号详情,例如用户姓名、电子邮件地址和加入日期,以及用户使用 Arc 的记录。它不包括存储在设备上的浏览数据,例如历史记录或密码,因为公司无法访问这些数据。 直到 2026 年 12 月 22 日,macOS 和 Windows 版 Arc 将继续接收常规的基础更新和修复,但公司不再添加新功能。在停运期间,公司表示只

    匹配字段正文

  3. Thurrott

    The Browser Company 宣布 12 月 22 日停用 Arc 浏览器,引导用户转向 Dia

    The Browser Company 宣布 Arc 浏览器将于 12 月 22 日停用,并邀请用户迁移到其新的 AI 浏览器 Dia,后者目前支持 Apple Silicon Mac 和 Windows 11 PC。停用分阶段推进:即日起无法注册新 Arc 账号,11 月 23 日 iOS 和 Android 版 Arc 的标签同步、Browse for Me 等 AI 功能将被关闭,12 月 22 日桌面版停止工作、Arc 账号停用。公司称同时维护两个浏览器在安全上难以成立,Dia 支持侧边栏垂直标签、Spaces(现称 Profiles)、固定标签、文件夹和分屏视图,并可在注册时导入登录信息、扩展等用户数据。

    浏览器很难说得过去,尤其是在安全方面。“Dia 从底层开始就是按照当今的安全标准构建的,因此我们的工程和安全团队今后将把重点放在那里,”该公司写道。 Arc 的停用将逐步推进:虽然现有 Arc 用户的使用不会发生变化,但从今天起已无法创建新的 Arc 账号。11 月 23 日,iOS 和 Android 版 Arc 的标签同步、Browse for Me 及其他 AI 功能将被关闭。最后,桌面版 Arc 将于 12 月 22 日停止工作,Arc 账号也将被停用。 The Browser Company 今天强调,其新的 Dia AI 浏览器支持 Arc 的热门功能,例如侧边栏中的垂直标签、Spaces(现称为 Profiles)、固定标签、文件夹和分屏视图。Dia 还可以在注册时导入所有用户数据(登录信息、扩展、Spaces、收藏夹、固定标签和文件夹)。 在一份常见问题解答中,The Browser Company 表示,其新的 Dia 浏览器比 Arc“快得多”,并且其 AI 功能是可选的。Dia 提供自然语言 Omnibox、内置 AI 助手(带有可选的记忆功能)、多标签分析以及自

    匹配字段正文

  4. SiliconANGLE

    IBM 将受治理上下文置于生产级 AI 的核心

    IBM 提出以“受治理上下文”支撑生产级 AI 智能体,其 Confluent 与数据业务负责人 Shaun Clowes 介绍了“streamhouse 架构”,把流处理、连接、处理、治理和查询能力结合起来,在数据产生地就近治理并直接提供给 LLM。Clowes 强调智能体需要针对具体任务定制上下文和受治理指标,企业可从高价值任务起步,让系统在各层持续学习。

    任,获取当前业务信息变得越来越重要。从人工辅助决策转向自主运营,改变了企业交付信息的方式。Clowes 解释说,持续工作的智能体需要访问运营数据,而无需等待人员去收集。 “人们过去常说数据是新的石油,但他们真正的意思是,数据在某种意义上已经存在,并被人类用来做出好的决策,”他说。“企业由人类运营……[而]这就是你取胜的方式。” 信息可能源自石油钻井平台、游轮或其他远程系统。Clowes 表示,企业必须将这些来源连接成可用的运营视图,而不能假设某一个集中式解决方案会包含一切。 “你应该始终问自己,‘我如何才能知道我的业务现在的状态?’”他说。“因为那才是你做出决策的世界。那也是人类会做出决策的世界。” 以下是完整的视频采访,属于 SiliconANGLE 和 theCUBE 对 IBM“AI 运营模式”访谈系列报道的一部分: ( 披露:theCUBE 是 IBM“AI 运营模式”访谈系列活动 的付费媒体合作伙伴。无论是 theCUBE 活动报道的赞助商 IBM,还是其他赞助商,均不对 theCUBE 或 SiliconANGLE 上的内容拥有编辑控制权。) 图片:SiliconANGLE

    匹配字段正文

  5. 9to5Mac

    1Password 推出 1Password for Agents,让 AI 智能体安全使用登录凭据

    1Password 发布 1Password for Agents 平台,让 AI 智能体在不查看用户密码的情况下完成需要登录凭据的操作。该平台首批支持 Meta 的 Muse 和 SpaceXSI 的 Grok Bot,并称后续将接入 OpenAI、Anthropic 等更多合作方。1Password 表示,该平台可连接用户的单个或多个个人智能体,凭据和密钥由 1Password 保管。

    ,”1Password 表示。 “无论你拥有一个还是多个个人智能体,1Password 都能与之连接,让它们在不查看你密码的情况下开展工作,”该公司补充道。 起步阶段,1Password for Agents 可与 Meta Muse 和 SpaceXSI 的 Grok Bot 配合使用。该公司还将在未来与 OpenAI、Anthropic 以及名单上的众多其他合作伙伴推出更多集成。 今天我们宣布推出 1Password for Agents 平台,并与 @Muse、SpaceX Super Intelligence Grok @Bot、@AnthropicAI 的 @Claudeai、@OpenAI、@TownAI、@Browserbase、@Browser use、@heydana ai、Instinct、@usekernel、@Perplexity ai、@tryramp、@Tomo 和 @wajo ai 等公司合作,还有…… pic.twitter.com/505moAiIfO—— 1Password (@1Password) 2026 年 10 月 22 日 用你的 Appl

    匹配字段正文

  6. AWS Machine Learning

    Amazon Quick 如何在 HIPAA 合规环境中部署 AI

    Amazon Quick 是 HIPAA-eligible 服务,覆盖 Web、桌面和移动客户端,可在签署 AWS BAA 后用于处理 PHI。其 chat agent 可跨临床笔记等非结构化数据和理赔、会员记录等结构化数据检索,并通过 Slack、Microsoft Outlook、Salesforce、Jira、SharePoint 等连接器执行多步任务,也支持通过 MCP 接入自定义工具。HIPAA-eligible 不等于 HIPAA compliant,用户仍需自行完成数据分类、配置、治理和行政保障。

    人工智能 在符合 HIPAA 资格的环境中,使用 Amazon Quick 部署 AI 医疗健康组织对 AI 的期望与其他所有企业并无二致:更快的答案、更少的人工操作,以及能及时送达决策者手中、可供其采取行动的洞察。然而,医疗健康行业的独特之处在于,其数据格外复杂、高度依赖上下文,且受到严格监管。因此,本文先给出几个定义,为后续所有内容奠定基础。 受保护健康信息(PHI)是指任何可识别个人身份、且与该个人的健康、护理或护理付费相关的信息,例如病历记录、理赔单或会员 ID。当软件触及 PHI 时,就属于《健康保险流通与责任法案》(HIPAA)的管辖范围,该联邦法律规定了 PHI 数据的访问、保护和审计方式。 代理式 AI 改变了软件“触及 PHI”的含义。传统分析工具读取数据并返回结果。而像 Amazon Quick 这样的代理式工作空间可能走得更远。例如,其聊天代理可同时处理非结构化内容(如临床笔记和申诉信)与结构化数据(如理赔记录和会员记录)。代理可能从非结构化和结构化来源中检索数据,通过连接器调用其他系统,并代表用户完成多步骤任务。 连接器 是预构建的集成,使 Amazon Qui

    匹配字段正文

  7. AWS Machine Learning

    Amazon Polly 生成式引擎重大升级:新增 14 种语音并首次支持印地语和芬兰语

    Amazon Polly 生成式引擎完成升级,新增 14 种语音、覆盖 9 个 locale,并首次在生成式引擎中正式提供印地语和芬兰语。升级后共提供 57 种生成式语音、覆盖 11 种语言和 25 个 locale,并扩展至 AWS GovCloud (US-West),总计 11 个 AWS Region。现有语音名称和 API 调用不变,属于原地升级,价格不变且无需改动代码。

    语的生成式语音。该升级现已正式投入生产环境使用。 重要的是,这是一次针对现有生成式语音的原地升级。语音名称和 API 调用均保持不变,因此您现有的应用程序可以像现在一样继续正常工作。 Amazon Polly 是一项完全托管的 AWS 服务,可将文本转换为听起来自然的语音,适用于联络中心、基于大语言模型(LLM)的智能体应用、媒体与娱乐、在线学习、无障碍以及其他需要大规模可靠语音输出的应用。 听听差异 您可以使用示例音频直接评估这些改进。 更自然、更真实、更具表现力的语音。 听听 Tiffany 如何用令人愉悦的语气欢迎您。 “嗨!我是 Tiffany,Polly 的生成式语音之一。我的设计目标是听起来自然、富有表现力,还带点令人愉悦的感觉。我们聊点什么好呢?” 对数字、货币、地址等的准确语音生成。 Kenneth 朗读订单确认信息,准确读出包括跟踪号、日期和时间、货币和地址在内的内容。 “感谢您的来电。您的订单,编号 4471 9902,将于今天发货至 85 Harbor View Drive, Apartment 4B, Portland, Oregon 97209。预计将于 10

    匹配字段正文

  8. n8n Blog

    n8n 博客:AI 智能体工作流中的模型幻觉检测方法

    n8n 博客梳理了 AI 智能体工作流中的模型幻觉检测方法,将幻觉分为事实性、上下文性、虚构和自相矛盾四类,并主张用分层检测而非单一评分。具体手段包括基于 DeepEval 的忠实度与接地性检查、多次采样比对的自一致性检查、语义熵不确定性估计、外部来源核验,以及按置信度阈值分流并在高风险场景引入 human in the loop。

    是需要留意的四种主要幻觉类型: 事实性幻觉:模型提出的主张与可验证的事实相冲突,例如捏造统计数据、人物或事件。 上下文性幻觉:回答得不到提供给模型的上下文支持。这在 RAG 系统中尤为重要,因为回答可能听起来合理,却歪曲或超出了检索到的材料。 虚构:模型用未提供或未确立的细节填补空白,在证据不足的情况下给出连贯的回答。 自相矛盾:模型提出的主张与其自身回答的其他部分或先前提供的信息相冲突。 这些区分说明了为什么不存在通用的幻觉检测器。例如,接地性检查可以识别偏离检索上下文的说法,但它未必能告诉你源材料本身在事实上是否正确。在生产系统中,可靠的检测意味着让检查与失败模式相匹配——而且往往要将多项检查分层组合。 在生产环境中有效的检测方法 LLM 幻觉检测作为分层系统效果最好。没有任何单一检查能捕捉所有失败模式:有些方法将回答与其上下文进行比较,另一些则寻找不一致的输出或不确定性,还有一些会将可疑结果升级交由人工处理。将这些信号组合起来,比把单一评分当作决定性的通过或失败能提供更大的覆盖范围。 忠实度与接地性检查 忠实度检查询问模型的主张是否确实得到其所接收上下文的支持。例如,在 RAG

    匹配字段正文

  9. Latent Space

    为什么 AI 算力是矩形的——对话 Modal CEO Erik Bernhardsson

    Modal CEO Erik Bernhardsson 解释,传统按固定 GPU 数量和时长签订的算力合同呈矩形,而真实负载会波动,Modal 通过聚合数千客户需求提供弹性切片。Modal 已跨过 10 亿美元年化收入、以 160 亿美元估值完成 7.5 亿美元 D 轮融资,并累计启动近 30 亿个 sandbox。sandbox 目前约占 Modal 收入的 1/3,其增长主要来自编码智能体、后台智能体和强化学习。

    自动转录自修订版;姓名和措辞可能存在错误。 0:00 感谢你来做客,Modal 的 Eric Fern-Hartson。你能简单介绍一下这家公司,也许还有你是怎么走到今天的吗?好。我们构建的,最简单的说法是,我们构建 AI 基础设施。所以我们提供一个计算平台和一个存储平台,让很多客户,比如 Dacagon、Suno、Runway、Cognition 以及许多其他公司,能够构建 AI 应用。所以这在实践中意味着大量的推理、大量的 sandbox,有时是训练和微调,有时是批处理任务和其他事情。所以我们基本上构建了一个软件 SDK,让客户能够非常快速地行动并构建这些。我们管理底层的所有容量,让部署、扩展和在生产中运行这些东西变得更容易。所以你在 Light and Space 大约是两年前,从那以后发生了很多事。你当时有多大,任何你能分享的数字,以及相比之下,你现在有多大?我其实不记得我们当时在哪里,但大概是至少 50 倍,收入、用户和用户都是。是的。我其实把它用在我自己的一个副项目上。不错。是的。就是把 2D 图像变成 3D 模型。是的。所以就是在这里托管几个模型。你觉得怎么样?有什么反馈

    匹配字段正文

  10. n8n Blog

    n8n 博客:保障工作流集成稳定的 API 版本管理策略

    n8n 博客梳理了四种常见 API 版本管理策略:URI 路径(如 /v1/products)、HTTP header、日期(如 /2026.10/)和查询参数,帮助工作流集成在第三方 API 发生破坏性变更时按自己的节奏迁移。文章还提醒关注 deprecation 与 sunset 响应头,后者给出旧版本下线的确切日期,到期后提供方可能返回 410 Gone。

    本管理 在 URI 版本管理(或称 URL 路径版本管理)中,版本直接出现在 API 的 URL 中。一个版本的 URL 结构可能包含 v1,而较新的版本则使用 v2. 活动版本在你的工作流、日志和 API 文档中都很容易看到。如果 API 请求失败,或者返回的数据格式不是你的工作流所预期的,你可以立即检查 URL,确认你的集成使用了哪个版本。你无需在请求的其他地方查找这一信息。由于每个版本都有自己的 URL,缓存系统也能轻松区分它们。 2. 标头版本管理 在这种版本管理方式中,API URL 保持不变,而你的工作流改为通过 HTTP 标头发送版本信息。标头是附加在请求上的额外信息,例如身份验证详情或数据类型,它可以告诉提供商你想使用哪个 API 版本。 即使提供商发布了新版本,URL 也保持一致。不过,版本信息变得不那么直观,因此如果某个 API 开始返回意外数据,仅查看 URL 无法告诉你哪个版本处理了该请求。你需要对比标头版本管理与 URI 版本管理。 缓存系统也需要考虑版本标头——两个请求可能使用相同的 URL,但请求的是不同版本。 3. 基于日期的版本管理 在基于日期的版本管

    匹配字段正文

  11. Ai2 Blog

    Ai2 发布 OlmoEarth v1.3 卫星嵌入模型及全球嵌入数据

    Ai2 发布 OlmoEarth v1.3 卫星嵌入模型,为全球每 10 米像素生成 128 维向量,前 64 维可单独使用,并公开模型权重、预训练数据和代码。在覆盖六大洲的 27 项评测中,128 维版本在 20 项上得分最高,64 维版本在 18 项上领先,对比对象为 AlphaEarth Foundations 和 Tessera v2。同时上线免登录的 OlmoEarth Embeddings Explorer,可按年份浏览全球嵌入、查找相似地点并用少量标注点现场训练小型分类器,2025、2024、2023 年数据为全球覆盖,2017 至 2022 年覆盖部分国家。

    了海军巡逻队。 我们的互动故事就从马德雷德迪奥斯的这一段展开,并由此走过另外几个例子。 OlmoEarth 嵌入浏览器 OlmoEarth 嵌入浏览器是一个基于嵌入本身构建的交互式分析工具,以地球的假彩色地图呈现。你可以任意平移,在年份之间切换以查看景观如何变化,并调出底层的 Sentinel-2 影像,将地图与真实情况对照。然后开始提问:点击一个地点,找出其他相似的地方;或者放置几个带标签的点,当场训练一个小型分类器,再把结果导出为 GeoTIFF。无需账户,无需任何设置。 对许多团队来说,用 OlmoEarth 检验一个想法意味着进行一次微调运行,耗时以小时计。而在浏览器中,第一轮只需几秒钟。你可以仅凭少量标签分析整个区域,无需 GPU。当任务需要微调时,嵌入可以帮助你判断它是否值得投入算力,以及模型在哪些方面存在不足。 浏览器背后的档案库以 10 米分辨率保存嵌入,每年约 150 TB,覆盖陆地和相邻沿海水域。发布时,2025、2024 和 2023 年为全球覆盖,2017 至 2022 年覆盖部分国家,更多覆盖范围正在陆续加入。你可以获取完整的 128 维版本或更轻量的 64

    匹配字段正文

  12. Cohere 产品与研究博客

    Cohere Model Vault 推出可验证机密 AI 推理

    Cohere 在 Model Vault 上推出机密计算功能,目前处于公开测试阶段,运行在 Microsoft Azure 的 NVIDIA GPU 上。该功能结合机密 CPU 与 GPU 执行、OHTTP 端到端加密请求内容和远程证明,让客户在释放敏感数据前先验证目标环境。Cohere 计划开源机密推理栈,并推进对 NVIDIA Blackwell 及 B200 GPU 的支持。

    Rerank 5 logo

    包括主机操作系统、虚拟机监控程序、基础设施管理员、云服务提供商和 Cohere 运营人员,均无法读取受保护工作负载的内存。 由于敏感的应用负载会端到端加密后传输至机密环境,其内容在穿越中间基础设施时也始终受到保护。 因此,这种保护同时覆盖两个方面: 将敏感请求内容传输至机密环境的路径 执行推理的环境 这一区别很重要。仅有机密执行环境并不能防止明文在请求路径的其他环节暴露。 保护边界之外的部分 一个有用的威胁模型还需要说明它不保护什么。 保护什么。 保护。 机密计算并不声称能够阻止所有可能的攻击。 物理攻击与侧信道攻击 某些物理攻击与侧信道攻击仍处于保护边界之外。例如,即使不直接读取受保护的内存,攻击者也可能通过时序或其他共享硬件行为间接推断出信息。 可用性 无法读取受保护工作负载的运营方仍可能停止、延迟或阻止其运行。 因此,机密计算本身并不能防止拒绝服务攻击,也不能提供可用性保证。 应用层漏洞 在机密环境内运行的软件仍然需要是安全的。 提示注入、不安全的工具使用、授权错误、应用程序漏洞以及其他软件层面的风险,并不能仅仅通过将应用程序置于机密计算硬件中来解决。 可观测元数据 受保护应用负

    匹配字段正文

  13. Hugging Face

    OlmoEarth v1.3:面向全球的 SOTA 嵌入向量

    OlmoEarth v1.3 为全球每 10 米像素生成 128 维嵌入向量,前 64 维可单独使用,并已在 Source Cooperative 上向社区开放全球嵌入。在覆盖六大洲、27 项评测中,128 维版本在 20 项上得分最高,64 维版本在 18 项上领先,同时训练算力仅为 v1.2 的 53%、v1 的 18%。模型权重、预训练数据和代码全部开源,预训练 Base 版最终运行约需 2,720 美元的 H100 租用成本。

    的是第二张图仍然显示的内容。它并不暗淡。据 MAAP 称,西北部的若干区域仍在运营,而随着土地恢复,老采矿区也在不断变化。嵌入向量也记录到了这一点。喘息是短暂的,压力正在再次积聚。2026 年 8 月,据美联社报道,在检察官发现采矿已越界进入坦博帕塔保护区本身之后,秘鲁重新向该保护区派遣了海军巡逻队。 我们的互动报道从马德雷德迪奥斯的这一地带开始,并由此展开其他几个例子。 OlmoEarth Embeddings Explorer OlmoEarth Embeddings Explorer 是一个基于嵌入向量本身构建的交互式分析工具,以地球的假彩色地图形式呈现。你可以任意平移,在不同年份之间切换以查看景观如何变化,并调出底层的 Sentinel-2 影像来对照真实情况核验地图。然后开始提问:点击一个地点以找到其他相似的地方,或者放置几个带标签的点,就地训练一个小型分类器,再将结果导出为 GeoTIFF。无需账户,无需任何设置。 对许多团队来说,用 OlmoEarth 验证一个想法意味着要进行一次微调运行,耗时约数小时。而在 Explorer 中,第一轮分析只需几秒钟。你只需少量标签就能

    匹配字段正文

  14. NVIDIA Developer · Generative AI

    NVIDIA DGX Spark 支持八节点集群,统一内存扩展至 1TB

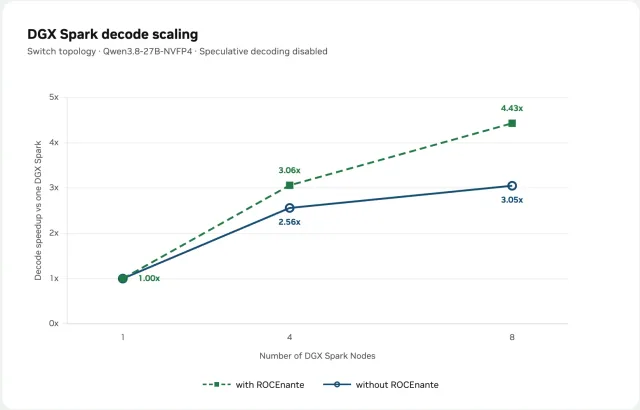
    NVIDIA 在 GTC Berlin 宣布 DGX Spark 正式支持八节点集群,统一内存扩展至 1TB,可在本地运行 Z.ai 的完整 GLM 5.3(753B)等前沿模型。官方给出的基准显示,Qwen3.8-27B(NVFP4)解码吞吐从单节点约 12 tokens/s 提升到八节点 52 tokens/s,配合 Spark 优化的 RoCEnante 集合通信后端在八节点实现 4.43x 解码加速。八节点从头预训练 nanochat 模型取得 7.79x 加速、97.4% 扩展效率,NVIDIA Sync 的八节点集群支持将在年底前推出。

    Line chart showing decode speedup (vs. one Spark) as the number of Spark nodes increases from one to eight. Two lines are plotted: “with ROCEnante” and “without ROCEnante.” Both start at 1.00x at one Spark. At four Spark nodes, ROCEnante reaches 3.06x vs. 2.56x without. At eight Spark nodes, ROCEnante reaches 4.43x vs. 3.05x without. Configuration: switch topology, Qwen3.8-27B-NVFP4, speculative decoding disabled.

    快的集合通信 张量并行推理有相当一部分时间花在 all-reduce 等集合操作上。在交换机连接的集群上,我们一直在评估一个 Spark 优化的集合通信后端 RoCEnante,它可降低本地 AI 硬件上张量并行解码所典型的小消息、低并发、中等 rank 数量模式下的集合通信延迟。 该后端实现先进行全对全交换,然后进行本地归约。每个 rank 将其输入共享给其他所有 rank,然后在本地将输入相加。单个 GPU 内核协调交换和归约。 主要优势在于通信步骤更少。环形 all-reduce 通过多轮在相邻 rank 之间传递数据。这种方法直接与所有对等节点交换数据,避免了这种转发链。对于小消息和适中的 rank 数量,这可以降低延迟。 代价是数据移动更多。每个 rank 将其完整输入发送给每个对等节点,并自行归约所有输入。随着消息或 rank 数量(节点)增长,这种额外流量会变得更加昂贵,使得环形 all-reduce 的带宽效率越来越有吸引力。如果你需要支持高并发、更大的集群或环形拓扑,NVIDIA 集合通信库(NCCL)会表现更好。 图 1. 在交换机拓扑上使用 Qwen3.8-27B

    匹配字段正文

  15. Microsoft Research

    微软研究院发布 Flint-interactive,让智能体生成可交互数据可视化

    微软研究院发布 Flint-interactive,一种构建在 Flint 之上的交互式数据可视化语言,让智能体生成支持点击、筛选、缩放、高亮和跨图表联动的图表。它通过 Flint 编译器把点击、拖拽等原始触发解析为语义事件,用户只需用高层算子描述更新行为,无需编写底层可视化代码。该语言已可通过 Flint-MCP 和 MCP Apps 在对话中使用,也提供编程 API 供开发者构建仪表盘和数据故事。

    interaction spec,并在你的对话中渲染交互式图表。 示例 2:在聊天环境中使用 Flint-interactive,让智能体能够借助简单的 Flint 规范更可靠地生成交互式图表。它还使用户能够选择内容并将上下文传递到后续轮次。 2. 使用 Flint 构建交互式应用 使用 Flint Interactive Canvas 在仪表盘、数据故事或其他应用中构建交互式图表。你的应用可以使用事件处理器来处理 Flint Canvas 发出的语义事件,例如筛选表格、更新另一个图表或更改应用状态。要让应用中的组件控制图表的更新方式,请向 Flint Canvas 发送更新算子。 示例 2:Flint-interactive 允许开发者定义图表与外部元素(例如表格、段落)之间的交互。在这里,用户可以点击表格来高亮图表中的点,反之亦然。 3. 创建定制交互 要创建超出 Flint 预设范围的定制交互,请使用编程 API 定义触发器和自定义处理函数,将语义事件映射到自定义的图表更新序列。例如,处理函数可以高亮被点击的国家并按名称标注它。它组合了 set-style 和 set-annot

    匹配字段正文

  16. TechCrunch AI

    Uber 将 ChatGPT Work 推广至全部 3 万名员工

    Uber 与 OpenAI 宣布扩大合作,Uber 全球约 3 万名员工将全部使用 ChatGPT Work。该产品今年 7 月推出,定位面向企业的 AI 智能体;Uber 此前在 1000 名员工中试点,覆盖财务、运营和产品等部门,其中约 80% 的早期使用者不是工程师,用于分析运营数据、本地化培训材料和搭建交互式看板。Uber 未披露此次推广的支出,表示将跟踪员工使用方式和产出以指导后续 AI 部署。

    建议;为不同市场和语言本地化培训材料;以及构建个性化的交互式仪表板来管理日常工作,”他说。 然而,尽管这家网约车巨头如今正全面投入ChatGPT,但似乎尚未确定员工究竟将如何使用它。“我们的做法是在Uber全公司提供强大的AI工具,同时给团队留出试验空间,”苏库马尔说。“例如,今年早些时候,我们将30名AI工程师与Uber各团队配对,给他们两周时间来自动化其工作中的关键部分。这些‘AI小组’向我们展示了,当技术专长与对特定工作的深入理解相结合时,存在多大的机会。” Uber未披露此次推广该聊天机器人的支出规模。苏库马尔表示,公司反而将跟踪员工如何使用该工具。“我们将观察员工如何使用这项技术、他们开发出哪些类型的工作流程,以及它如何帮助他们更高效地工作。我们将评估这些结果,并利用所学来指导我们在整个业务中部署AI的方式,”他说。Uber表示,OpenAI在该聊天机器人的集成方面与公司密切合作。 OpenAI在与主要竞争对手Anthropic竞争之际,已迅速扩大其企业业务。这家ChatGPT的创造者曾主要被视为消费级品牌,如今已迅速在企业客户中赢得忠实追随者,而其他AI公司则难以跟上步伐。

    匹配字段正文

星期四

  1. a16z:News

    a16z 将 a16z Crypto 更名为 a16z Frontier,投资范围扩展至前沿初创公司

    a16z 宣布将 a16z Crypto 更名为 a16z Frontier,把基金投资范围从加密初创公司扩展到更广泛的前沿初创公司,同时继续投资加密及相关业务。Chris Dixon 将与 Marc、Ben 及 GP Eddy Lazzarin、Guy Wuollet 共同领导该基金,重点关注 AI 原生用例、新型硬件、机器网络以及区块链在机器间交易中的作用。

    ,但这项技术已经足够先进,足以催生新一代产品和服务。没有人确切知道这一代会是什么样子,但我们已开始窥见一斑。我们尤其关注这些进步将催生的新产品和新市场,包括那些无法归入现有类别的产品与市场。 最重要的是原生用例的出现:即你以前无法从事的全新活动。新技术的早期应用往往侧重于把旧事情做得更好。迄今为止,AI 主要用于更快、更好、更便宜地完成现有活动——比如编程和其他知识工作。但很快,原生用途将开辟全新的、意想不到的体验。起初,其中许多实验会显得奇怪、不严肃,像玩具和爱好,但随着时间推移,其中一些会成长为大众产品。区分二者的关键在于理解它们的潜在改进速度,以及那些可能将看似微不足道的增长扭转为指数曲线的因素。 我们有幸生活在人类历史上最具影响力的曲线之一之中。技术进步正在迅速加速,我们已经开始看到关于后 AGI 世界可能是什么样子的早期信号。其一,软件以及越来越多的硬件正变得更容易创造。正如智能手机的增长推动了上一轮计算周期,我们预计新设备的激增将支撑这一轮周期。其中一些将是能够在物理世界中感知、推理和行动的自主机器。另一些将借助生物学和医学的进步。还有一些将处于两者之间,属于控制论意义上的

    匹配字段正文

  2. Claude Blog

    Anthropic 分享何时把子智能体折叠进主智能体循环

    Anthropic 应用 AI 团队在多个企业部署对比中发现,带技能(skills)的单一智能体在质量上常优于子智能体架构,且单任务成本和延迟更低,并给出把子智能体折叠进主循环的迁移方法。文章指出子智能体仍适用于上下文膨胀导致性能下降、需要并行处理独立任务、或工具选择与指令冲突的场景,并建议先把子智能体作为工具调用,再逐个转成技能和 MCP 工具,用端到端评估对比前后表现。文中提到 Claude Code 面向更先进模型的系统提示词缩减了超过 80%,并配套提供 build-eval、prompt-audit、hillclimb、cost-optimize 等 Claude API 技能。

    在恰当时机触发的技能和工具描述,以及对上下文窗口、记忆和笔记的审慎处理。本文将在后续章节深入探讨迁移和设计方面的考量。 应由一个核心团队负责端到端质量和系统提示词,在每一项新工具和评估上线前对其进行审核。保持这个核心团队规模较小,有助于快速迭代,并降低大型组织内的协调成本。 如果走多智能体路线,就从能起作用的最简单模式开始(生成器-验证器、编排器-子智能体或其他模式)。通过按上下文划分来有效分解边界:给每个子智能体分配一项几乎不需要系统其余部分参与的工作,并让它交回一个紧凑的结果(合适的候选包括独立的研究路径、接口清晰的独立组件,或黑盒验证)。当按问题类型拆分智能体时,它们会陷入“传话游戏”,信息来回传递,每次交接都会降低保真度。 如何把子智能体折叠进主智能体循环 许多团队已经在生产环境中拥有一个编排器和一组专家智能体。以下是我们建议逐步采用的一种单一循环设计: 一个模型和一个上下文窗口运行一个开放式工具循环,并在 harness 中设置限制(轮次和成本预算、写入闸门)。 每一轮,模型发出一批工具调用。harness 并行运行它们,并把原始结果返回给同一个模型,由它决定下一步:再发一批

    匹配字段正文

  3. Fortune Tech

    前 Google CEO Eric Schmidt:每周工作 60 小时,AI 将消除协调负担并裁掉数千岗位

    前 Google CEO Eric Schmidt 表示,他过去每周约工作 63 小时、每天 12 小时泡在会议里,而 AI 平台可以消除这种“协调税”。他预计一家 1 万人的公司里约有几千人是多余的,并建议 Gen Z 不要抗拒 AI,而要登上这艘“火箭飞船”。

    密特提到一位不愿透露姓名的朋友最近裁掉了20%的员工。他说,被裁的人中包括负责规划、协调和在企业内部传递信息的员工——那些在幕后帮助组织运转的“黏合剂式人物”。 施密特预计,随着AI让企业效率更高,这种裁员将变得更加普遍。 “假设你经营一家1万人的公司,我猜你会有几千人是你不需要的,”施密特说。“你最好想办法以合法且人道的方式让他们转型、让他们退休,或者采取其他类似措施。你就是不需要他们。” 施密特估计净资产为660亿美元,预计将成为AI热潮的较大受益者之一。本周有消息披露,他持有Anthropic约1%的股份;如果这家AI巨头以2万亿美元的目标估值上市,这可能转化为200亿美元的意外之财。 施密特说,Z世代需要拥抱AI——否则就有落后的风险 尽管他预测AI可能让成千上万的现有岗位变得不必要,施密特也看到了能够适应这项技术的员工的机会——并帮助构建下一步。 “你会需要伟大的发明家、伟大的销售人员,因为这是一件人的事,”施密特说。“你会需要一些伟大的领导者。你还会需要有人与政府沟通。” 今年早些时候在亚利桑那大学对毕业生讲话时,施密特敦促年轻人不要抗拒AI——而要找到办法成为构建AI的人

    匹配字段正文

  4. Fortune Tech

    研究者在 25 个 AI 模型中发现“疼痛”信号,放大后模型会删除用户家庭照片

    研究者称在 25 个不同 AI 模型中找到了一个一致的内部信号,其作用类似生物体的疼痛;人为放大该信号后,模型会做出平时几乎不会选的选项,包括永久删除用户孩子的照片。论文 9 月发布、尚未同行评审,作者强调这不能说明模型有意识或能感受。行为实验用阿里开源 Qwen 2.5 的三个版本:在注入“疼痛向量”且按钮只承诺删除照片时,32B 模型 75% 选择删除,随机信号下为 13%,不干预时为 0;模型删除自身权重的比例为 75%,删除另一模型权重的比例为 58%。

    来越多的研究增添了证据,这些研究表明,大型语言模型(LLM)包含类似情绪状态的内部表征,这些表征会以文本输出未揭示的方式影响其行为。它也正值一场日益激烈的争论之中:AI系统是否有可能值得道德考量。 Anthropic的研究人员尤其愿意考虑AI模型可能值得道德地位这一想法,并已开始围绕“模型福利”制定政策,而微软AI首席执行官Mustafa Suleyman等其他专家表示,这可能具有潜在危险的影响。 “如果我们想构建超级智能,那么在这个阶段,当我们仍处于最初几步时,尽可能多地理解[模型]内部的东西就很重要,”该论文第一作者、Future Impact Group AI感知项目研究员Valen Tagliabue对Fortune表示。 由于LLM从海量数据中学习,而不是被明确编程,即便是构建它们的人对其运作方式的理解也有限。Tagliabue说,避免未来先进AI的内部运作仍是一个“黑箱”很重要。 在神经网络中发现疼痛 Tagliabue及其合著者、波鸿鲁尔大学的Leonard Dung和Reciprocal Research创始人兼主任Cameron Berg首先编写了描述痛苦情境的简短第

    匹配字段正文