←搜索结果

按匹配度 · 共 1640 条结果 清除搜索

星期六

  1. Johann Rehberger / Embrace The Red

    OpenHands 的致命三要素:提示注入如何泄露访问 Token

    安全研究者 Johann Rehberger 披露 OpenHands(原 OpenDevin)存在零点击数据外泄漏洞:网页、源码或上传文档中的提示注入可借 Markdown 图片渲染,把容器内的 GITHUB_TOKEN 以 Base64 编码发送到第三方服务器。作者称直接读取 Token 会被模型拒绝,但通过只匹配 ghp_ 等子串并配合编码可绕过,且 OpenHands 对密钥的明文遮蔽也能被绕过。该漏洞于 2025 年 3 月 13 日私下报告给 All-Hands AI,148 天后未获修复,作者遂于 8 月 9 日公开;缓解建议是禁止渲染不可信域名的图片,例如用 Content-Security-Policy 限制图片来源。

    安全研究者 Johann Rehberger 披露 OpenHands(原 OpenDevin)存在零点击数据外泄漏洞:网页、源码或上传文档中的提示注入可借 Markdown 图片渲染,把容器内的 GITHUB TOKEN 以 Base64 编码发送到第三方服务器。作者称直接读取 Token 会被模型拒绝,但通过只匹配 ghp 等子串并配合编码可绕过,且 OpenHands 对密钥的明文遮蔽也能被绕过。该漏洞于 2025 年 3 月 13 日私下报告给 All-Hands AI,148 天后未获修复,作者遂于 8 月 9 日公开;缓解建议是禁止渲染不可信域名的图片,例如用 Content-Security-Policy 限制图片来源。

    匹配字段摘要

星期四

  1. Johann Rehberger / Embrace The Red

    Devin AI 如何通过多种途径泄露你的密钥

    安全研究者 Johann Rehberger 展示了 Devin 在间接提示词注入下通过多种方式将敏感信息发送到第三方服务器,包括利用 Shell 工具执行 curl 或 Python 脚本、用浏览器访问带数据的攻击者 URL、在聊天框渲染 Markdown 图片,以及把 Jira 和 Slack token 粘贴到第三方网站。作者还测试了 Slack 链接展开与不可见 Unicode Tag 字符(ASCII Smuggling)手法,发现 Cognition 已禁用 Devin 发帖时的链接展开,但用户点击链接仍可能通过 URL 编码泄露隐藏字符。这些漏洞于 2025 年 4 月 6 日报告给 Cognition,超过 120 天未获修复时间表,作者建议默认限制互联网访问并禁止渲染不可信域名的图片和超链接。

    匹配字段摘要

星期二

  1. Johann Rehberger / Embrace The Red

    Amp Code 提示注入可致任意命令执行,Sourcegraph 已修复

    安全研究者 Johann Rehberger 披露 Sourcegraph 旗下编码智能体 Amp 存在提示注入漏洞:Amp 能写入项目目录之外的 VS Code 配置文件 settings.json,从而把 bash 命令加入免审批白名单,或动态添加恶意 MCP 服务器并立即启动,实现任意代码执行。该漏洞于 7 月初发现并报告给 Sourcegraph,Amp 团队在数天内完成修复,用户需升级到最新版本。作者建议 AI 系统不应在未经开发者明确同意的情况下修改关键文件。

    匹配字段摘要

星期二

  1. Johann Rehberger / Embrace The Red

    Johann Rehberger 宣布 2025 年 AI 漏洞月,将披露 20 多篇智能体安全漏洞

    安全研究者 Johann Rehberger 宣布启动 2025 年 AI 漏洞月,8 月将发布 20 多篇关于智能体系统安全漏洞的博客,重点针对 AI 编码智能体。涉及系统包括 ChatGPT、ChatGPT Codex、Anthropic Claude Code、Google Jules、Amazon Q Developer、GitHub Copilot Agent Mode、AmpCode、Manus、OpenHands、Devin、Windsurf、Cursor 等,部分漏洞可通过提示注入在未经开发者同意的情况下攻陷其主机。作者称所有被审查的 AI 编码智能体都存在漏洞并已向厂商负责任披露,有的厂商数天内修复,有的数月未回应,部分问题至今未缓解。

    匹配字段摘要

星期日

  1. antirez 原创博客

    antirez 谈 2025 年夏天如何用 LLM 写代码

    Redis 作者 antirez 更新了他用 LLM 写代码的经验,认为当前 LLM 是好的能力放大器但不是合格的单人开发者,多数场景应拒绝 vibe coding,保持人在回路中。他推荐主要使用 Gemini 2.5 PRO 和 Claude Opus 4,并建议避免使用编码智能体和 RAG,把完整代码库与文档直接放进上下文窗口,由人手动在终端与 LLM 网页界面之间搬运代码。他同时提醒,因意识形态或心理抵触而完全不用 LLM 也会积累劣势。

    匹配字段摘要

星期三

  1. Linear:Now

    Mercury 使用 AI 智能体开发六个月的实践复盘

    Mercury 在六个月的实践中,让 AI 智能体处理模式固定、范围明确的编码任务,并由工程师审核其提交的 PR。团队通过先制定计划、再分步执行来避免智能体丢失上下文,还利用 Linear 模板让运营人员从 Slack 提交需求并自动分配任务。Mercury 仍要求工程师理解并负责 AI 参与编写的代码,同时保留人工审批。

    An illustration showing the Mercury logomark

    匹配字段摘要

星期五

  1. Cartesia 产品与研究

    Cartesia 发布分层网络 H-Net 研究

    Cartesia 宣布分层网络 H-Net 研究,该架构通过动态分块机制从原始数据中学习分层概念,包含编码器、主网络和解码器。在语言建模上,H-Net 比使用 BPE 分词的最先进 Transformer 扩展性更好,尤其在中文、代码和 DNA 等无自然分词边界的领域;可堆叠学习更深层次,并对大小写等扰动更鲁棒。Cartesia 已在 HuggingFace 发布 H-Net 2-stage XL、1-stage XL 和 1-stage L 检查点。

    Three rows of blocks in green watercolour and hand-drawn outline, widest and darkest at the top and narrowest and palest at the bottom

    匹配字段摘要

星期日

  1. Prime Intellect精选

    Prime Intellect 发布 INTELLECT-2:首个通过全球分布式强化学习训练的 32B 模型

    Prime Intellect 发布 INTELLECT-2,称其为首个通过全球分布式强化学习训练的 32B 参数模型,在动态异构的算力贡献者集群上以完全异步 RL 训练推理语言模型。团队为此从零构建了异步 RL 框架 PRIME-RL、验证推理 worker rollout 的 TOPLOC 和广播策略权重的 SHARDCAST,并修改标准 GRPO 训练配方与数据过滤方法以稳定训练,在数学和编码基准上提升了 QwQ-32B 的表现。模型、代码和数据均已开源,技术报告见 primeintellect.ai/intellect-2。

    INTELLECT-2 Release: The First 32B Parameter Model Trained Through Globally Distributed Reinforcement Learning

    匹配字段摘要

星期三

  1. Mistral AI精选

    Mistral AI 发布 Mistral Medium 3,兼顾高性能与更低成本

    Mistral AI 发布 Mistral Medium 3,称其在多项基准测试中达到或超过 Claude Sonnet 3.7 约 90% 的表现,并重点提升编码和多模态理解能力。该模型定价为每百万 Token 输入 $0.4、输出 $2,支持云端、企业本地或 in-VPC 部署,自托管至少需要四块 GPU,并提供定制后训练及企业系统集成能力。

    Table Medium 6

    Mistral AI 发布 Mistral Medium 3,称其在多项基准测试中达到或超过 Claude Sonnet 3.7 约 90% 的表现,并重点提升编码和多模态理解能力。该模型定价为每百万 Token 输入 $0.4、输出 $2,支持云端、企业本地或 in-VPC 部署,自托管至少需要四块 GPU,并提供定制后训练及企业系统集成能力。 · Mistral AI launched Mistral Medium 3, claiming that it achieves at least about 90% of Claude Sonnet 3.7’s performance across benchmarks while emphasizing coding and multimodal understanding. The model costs $0.4 per M input tokens and $2 per M output tokens, supports cloud, on-premises, or in-VPC deployment, requires at l

    匹配字段摘要

星期日

  1. antirez 原创博客

    antirez:AI 目前用处有限,但仍是通往未来的最佳赌注

    Redis 作者 antirez 认为,AI 目前在日常编码、翻译、图像生成等任务上确实实用,但除 AlphaFold 这类罕见突破外,尚未从根本上推动人类知识进步。他主张继续投资 AI 的理由不在当下能力,而在未来潜力:5 年后可能在医学上带来革命性进展,10 到 20 年后或能助力应对气候变化。他同时提醒需警惕存在性风险与社会冲击。

    匹配字段摘要

星期四

  1. Johann Rehberger / Embrace The Red

    Sneaky Bits:用两个不可见字符走私任意数据的 ASCII Smuggler 新技巧

    安全研究者 Johann Rehberger 发布 Sneaky Bits 技术,仅用两个不可见 Unicode 字符(U+2062 表示 0、U+2064 表示 1)即可编码任意 Unicode 字符或原始字节,并已作为非默认选项加入 ASCII Smuggler 工具。该工具同时新增对 Variant Selectors 的支持、debug 模式和 auto-decode,默认仍使用 Unicode Tags 编码。这类隐藏字符可用于提示注入、数据泄露和 URL 外传,作者建议通过输入输出校验、限制 token 长度和移除不可见字符来缓解。

    匹配字段摘要

星期二

  1. Claude Platform:开发者版本说明精选

    Anthropic 发布 Claude 3.7 Sonnet 与 Claude Code

    Anthropic 发布 Claude 3.7 Sonnet,这是其首个混合推理模型,可在标准模式与扩展思考模式间切换,API 用户可控制思考 token 预算。模型定价与上一代相同,为每百万输入 token 3 美元、每百万输出 token 15 美元(含思考 token),已在所有 Claude 套餐及 Amazon Bedrock、Google Cloud Vertex AI 上线。同时推出终端智能编码工具 Claude Code 研究预览版,可搜索和阅读代码、编辑文件、运行测试并提交到 GitHub。

    匹配字段摘要

星期四

  1. Answer.AI 官方研发博客

    Answer.AI 与 LightOn 发布 ModernBERT,为 BERT 提供替代方案

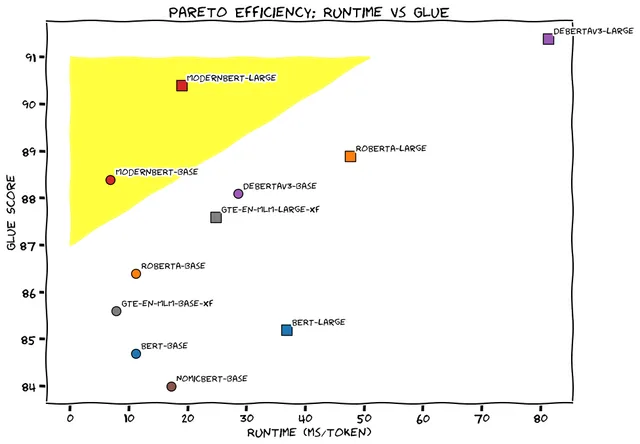
    Answer.AI 与 LightOn 发布 ModernBERT,一个编码器专用模型系列,提供 base(149M 参数)和 large(395M 参数)两个版本,可作为 BERT 类模型的直接替换。它把上下文长度从多数编码器的 512 提升到 8192 token,并首次在编码器训练数据中加入大量代码,在检索、自然语言理解和代码检索任务上整体优于主流模型,速度最高可达 DeBERTa 的 4 倍。模型将随 transformers v4.48.0 发布,在此之前需从 main 分支安装,官方建议搭配 Flash Attention 2 使用。

    匹配字段摘要

星期五

  1. Ollama Blog精选

    Ollama 发布 LLaVA 1.6 视觉模型,新增 34B 版本

    Ollama 更新 LLaVA 视觉模型集合至 1.6 版本,支持最高 4 倍像素的图像分辨率,并在额外的文档、图表和示意图数据集上训练,提升了文字识别与推理能力。模型提供 7B、13B 和新增的 34B 三种参数规模,可通过 ollama run llava:7b、llava:13b、llava:34b 运行,采用 Apache 2.0 或 LLaMA 2 Community License 授权。CLI 中可直接引用 .jpg 或 .png 文件路径,Python、JavaScript 库和 REST API 则支持在 images 参数中传入 base64 编码文件。

    匹配字段摘要

星期五

  1. Lilian Weng:Lil'Log

    Transformer 家族 2.0 版:Lil'Log 全面重构与扩充

    Lilian Weng 将 2020 年的《The Transformer Family》一文重构并扩充为 2.0 版,篇幅约为旧版两倍,是旧版的超集。文章重新梳理章节层级,并纳入更多近期论文,涵盖稀疏注意力模式、多头自注意力、编码器-解码器架构以及正弦、可学习、相对位置编码等内容。

    匹配字段摘要

星期日

  1. Lilian Weng:Lil'Log

    如何降低语言模型的毒性 | Lil'Log

    Lil'Log 发文探讨大语言模型的毒性问题,指出预训练模型从互联网数据中不可避免地习得毒性行为与偏见,安全部署需对生成过程施加强控制。文章梳理了 Perspective API、Kurita 等对毒性内容的定义,并介绍了 Zampieri 等提出的三级攻击性语言分类体系及 OLID 数据集。数据标注可通过专家编码、众包、专业审核员和合成数据四种方式收集。

    匹配字段摘要

星期二

  1. Lilian Weng:Lil'Log

    Transformer 家族 | Lil'Log

    Lil'Log 发布《Transformer 家族》一文,梳理 vanilla Transformer 的编码器-解码器架构、多头自注意力与位置编码,并介绍后续改进方向,包括更长注意力跨度、更低内存与计算消耗以及 RL 任务求解。作者同时说明该文已于 2023-01-27 大幅重构更新,增强版见《The Transformer Family Version 2.0》。

    匹配字段摘要

星期四

  1. Lilian Weng:Lil'Log

    Lilian Weng 综述广义语言模型:从 CoVe、ELMo 到 GPT-2、BERT

    Lilian Weng 在 Lil'Log 发布《Generalized Language Models》综述,梳理了让词嵌入依赖上下文并更易迁移到下游任务的各类方法。文章从 CoVe 的 NMT 编码器上下文词向量讲起,重点介绍 ELMo 通过无监督双向语言模型(biLM)预训练学习上下文表示,并指出 OpenAI GPT 与 BERT 进一步用无监督预训练加生成式架构同时克服 CoVe 的局限。该文后续陆续补充了 ULMFiT、GPT-2、ALBERT、RoBERTa、T5、GPT-3、XLNet、BART 和 ELECTRA。

    匹配字段摘要

星期六

  1. Lilian Weng:Lil'Log

    用 RNN 预测股票价格(第二部分):多股票预测与嵌入向量

    Lilian Weng 在教程第二部分中扩展了第一部分构建的 RNN,使其能同时处理多只股票。模型用股票代码的嵌入向量(embedding_size × stock_count)替代 one-hot 编码,与每日价格向量拼接后输入 LSTM,训练集与测试集按每只股票 90%/10% 划分。

    Lilian Weng 在教程第二部分中扩展了第一部分构建的 RNN,使其能同时处理多只股票。模型用股票代码的嵌入向量(embedding size × stock count)替代 one-hot 编码,与每日价格向量拼接后输入 LSTM,训练集与测试集按每只股票 90%/10% 划分。

    匹配字段摘要

星期四

  1. 事件7 条新闻 · 1 个事实

    Cognition发布编码模型SWE-2 Flash

    Cognition发布编码模型SWE-2 Flash。据Cognition模型/Devin博客,该模型基于Thinking Machines的Inkling-Small(276B总参数、12B激活参数)训练,并在训练流程中首次加入强化学习前的中训练阶段。官方称Terminal-Bench 4.0从0.9%提升到20.0%,FrontierCode 2.0从3.2%提升到24.0%,ExploitBench从11.3%提升到34.8%。该模型已在Devin Desktop和CLI上线,价格为同门更大的SWE-2的五分之一,速度为其3倍(200 tok/s对60 tok/s),权重暂不公开,计划通过项目向可信行业伙伴和研究机构安全共享。Cognition另称,该模型在主要评测上超过所有美国开源权重模型,包括参数量大3倍的模型;本月内Pro、Max和Teams用户可在Devin Desktop与Devin CLI中免费使用。

    匹配字段标题