vLLM公布FastGen性能对比
2023年11月14日,vLLM团队发布与DeepSpeed-FastGen的推理吞吐性能对比。结果显示,vLLM在常见场景中速度与后者相当,在较长输出任务中表现更快,其他场景最高可快1.8倍。DeepSpeed-FastGen仅在长提示词、短输出负载下凭借Dynamic SplitFuse占优,但实测增益未达到其宣称的2倍。
匹配字段摘要
2023年11月14日,vLLM团队发布与DeepSpeed-FastGen的推理吞吐性能对比。结果显示,vLLM在常见场景中速度与后者相当,在较长输出任务中表现更快,其他场景最高可快1.8倍。DeepSpeed-FastGen仅在长提示词、短输出负载下凭借Dynamic SplitFuse占优,但实测增益未达到其宣称的2倍。
匹配字段摘要
Manus 发布 2026 年游戏开发十大 AI 工具榜单,其中 GDevelop、Unity、Manus、Rosebud AI 用于构建游戏本体,Cursor、Convai、Scenario、Ludo.ai、Meshy、ElevenLabs 分别覆盖代码、NPC、2D 美术、3D 模型与音频。Manus 支持用一句描述生成可分享的浏览器游戏,免费起步、付费 $20/月起;GDevelop 免费开源,付费 $7.99/月起。所有价格按 2026 年 11 月 4 日月付口径统计。
推出 Manus 2.0其他·2026年11月6日星期五2026年游戏开发最佳 AI 工具:我们的十大精选游戏开发领域的 AI 工具如今几乎覆盖了游戏制作的每一个环节。有些能根据一段描述构建出可玩的游戏。另一些则专注于单一任务,比如代码、2D 美术、3D 模型、语音或会说话的角色。本指南对其中 10 款工具进行了对比。其中四款用于构建游戏本体:GDevelop、Unity、Manus 和 Rosebud AI。其余六款各自负责工作中的某一部分,比如代码、美术、音频或角色,你需要把它们的产出导入自己的引擎。结论基于官方文档和定价页面、第三方评测,以及游戏开发者在 Reddit 上的讨论帖。快速回答:•最佳 AI 游戏引擎:GDevelop 适合学习无代码游戏开发,Unity 的 AI 工具适合已经在 Unity 中开发的团队•最适合根据提示词构建可玩游戏:Manus 适合无需代码制作可分享的浏览器游戏,Rosebud AI 适合对社区游戏进行二次创作•最适合代码和角色:Cursor 适合编写和修复游戏代码,Convai 适合会说话、会行动的 NPC•最适合美术和音频:Scenario 适
匹配字段正文
Manus 博客盘点了 2026 年 10 款最适合初学者的 AI 游戏制作工具,按新手友好度排名,Astrocade、Manus、Aippy 获五星。Manus 于 2026 年 9 月随 Manus 2.0 推出 Game Dev 环境,可先选模板再用自然语言描述生成游戏,并在 Assets 标签页逐个修改素材;免费计划每天 300 credits,付费从 $20/月(4000 credits/月)起。榜单还列出 Rosebud AI、PlayDrop、Kimi、GDevelop、Replit 等工具的价格与免费额度。
推出 Manus 2.0其他·2026年11月6日星期五2026 年 10 款最适合初学者的 AI 游戏制作工具(无需编程)过去,你的第一个游戏往往要花上几周时间看教程,屏幕上才会有东西动起来。现在,你只需用一句话描述一个想法,当天下午就能玩到一个粗略的版本。但 AI 游戏制作工具并非可以随意互换。有些工具会把你的提示词变成一个可以在手机上分享的迷你游戏。另一些则是完整的游戏引擎,配有 AI 助手,帮你亲手构建游戏。本指南对比了 2026 年 10 款最适合初学者的 AI 游戏制作工具:每款工具擅长什么、在哪里不足,以及费用是多少,让你在花掉一个额度之前就能做出选择。 按新手友好度排名的最佳 AI 游戏制作工具 工具新手友好度最适合免费选项付费方案起价 Astrocade★★★★★获得真实玩家,免费免费制作和游玩游戏免费 Manus★★★★★用描述生成游戏并在无需代码的情况下完善它免费计划每天 300 额度$20/月 Aippy★★★★★在手机上快速制作迷你游戏免费,且无广告免费 Rosebud AI★★★★☆可发展为更大项目的浏览器游戏每周 10,000 额度(符合条件的地区)$15
匹配字段正文
蚂蚁 inclusionAI 开源 ASpec,一个用于投机解码 Draft 模型的高吞吐训练框架,基于 TorchSpec 代码库优化 Draft 前向、反向与优化器执行,并将训练与 Target 特征生成重叠。在 Qwen3-8B/4K 场景下,单 GPU Draft-only 达 15,256.44 input tokens/s,为 TorchSpec 的 1.96 倍、SpecForge 的 2.07 倍、AngelSpec 的 2.48 倍;8 GPU 在线稳态窗口为 77,721.37 tokens/s,对应 2.28×、2.50×、2.68×。框架支持 Qwen3-8B、Qwen3.5-9B Native MTP、Qwen3.8-27B 长上下文及 Ling tiny/flash 3.0/3.1 等 recipe。

由 Dense、Qwen MoE、Ling MoE 注意力结构 MHA/GQA、物化 MLA、滑动窗口注意力(SWA)、CSA、QSA、DSA 执行 序列打包、上下文并行、共享 Target 特征、静态多节点训练 支持的组合、训练阶段和导出格式参见 算法详情 和 结构阶段 。 Qwen 与 Ling 上的 DSpark/DFlash 是主要的优化和配方重点;其他已实现的 路径有明确的支持边界,DFlash2 仍处于实验阶段。 从首次多 GPU 运行扩展到静态多节点训练,支持 NVLink、TCP 和 RDMA 数据路径。 查看 支持的路径与限制,然后浏览 配方 获取起点。 从这里开始 运行源码安装; 容器 也可用。 选择 Qwen3-8B 或 Ling tiny 体验相同的双 GPU 计划、训练、 报告、恢复和导出工作流。 选择训练配方 并 准备训练数据. 配方涵盖 Qwen3-8B、Qwen3.5-9B 原生 MTP、Qwen3.8-27B 长上下文以及 Ling tiny/flash 3.0/flash 3.1。 在仓库根目录下: bash setup.sh source .ven
匹配字段正文
Thinking Machines Lab 发布第二代模型 Inkling 2 Small,采用 594B 总参数、17B 激活参数的 MoE 架构,支持图像输入和可变推理强度,在 Artificial Analysis Intelligence Index 上得分 31。模型先在 Tinker 上以闭源权重提供,计划在外部安全测试和红队评估完成后于下周以 Apache 2.0 许可开放完整权重。官方称其在长程智能体编码、视觉和知识工作上较上一代全面提升,训练包含 8.4 万亿 token 预训练和 1075 步、超 1700 万次 rollout 的联合 RL。
升更多;这些场景是我们根据客户用例精心设计的。例如,在一个公开的金融文档摘要任务上,从相近的低分起步,Inkling 2 Small 能快速适应,仅用 75 个训练步骤就达到 Inkling Small 的最终性能,并最终大幅领先。 评估模型可微调性 Inkling 2 Small 比我们之前的模型学习更快、最终性能更高,并且在强化学习微调环境中与同等规模的其他开源模型相比具有竞争力。我们使用公开的财报电话会议数据创建了一个带有专家判断的投资分析任务,类似于 客户使用 tinker 进行训练定制模型时所用的金融分析工作负载 。为确保公平比较,我们对每个模型进行了学习率扫描;所有模型均在 Tinker 上使用 Tinker Cookbook 抽象进行训练,采用我们的 异步 RL 实现 和 Stable Reinforce 损失函数,训练超过 200 步。Inkling 模型的结果为 3 个随机种子的平均值;其他模型为单次运行。成本通过将采样和训练 token 数乘以当前 tinker 每 token 定价估算;对于采样,我们假设同一组内 rollout 中存在前缀缓存命中。 推理、知识与
匹配字段正文
Sierra 发布 Accelerators,为零售、医疗、保险、银行、电信等行业提供开箱即用的高频客服工作流,并内置基础集成与护栏,首批已在 Agent Studio 上线。Accelerators 由 Sierra 维护更新,用户改动与底层工作流分开追踪,更新可继承且需用户确认后应用;配合 Ghostwriter 可在数分钟内完成业务定制。未来团队可自建 Accelerators 并在公司内共享,自建内容归企业所有、不出公司。

持续改进。Accelerators 会将你的改动与底层工作流分开追踪,因此当 Sierra 发布更新时,这些改动会被保留下来。在决定是否应用更新之前,你可以审阅完整的变更集——包括它们与你已定制内容的契合程度。 Accelerators 还能跨不同的软件系统工作。例如,交易查询 Accelerator 包含查找客户过往付款记录的工作流。你的公司将这一工作流连接到保存这些记录的系统,因此你无需替换业务现有的软件即可使用该 Accelerator。 很快,你的团队将能够自行构建 Accelerators,并在公司内部共享。例如,一个登录流程或一套经法务团队批准的护栏,可以只构建和测试一次,然后添加到其他智能体中,而无需每个团队重新创建。你的团队构建的内容始终归你所有,绝不会离开你的公司。 首批 Accelerators 现已在 Agent Studio 中提供,后续还将推出更多。如需了解更多信息,请联系你的客户团队。 订阅 Sierra 博客 获取新产品功能、客户动态等最新通知。$?/$ 了解 Sierra 能为你做什么 了解 Sierra 如何帮助你借助 AI 交付更好的成果。 了解更多
匹配字段正文
Anthropic 对齐科学博客发布研究,在七个多智能体环境中测量 Claude Opus 4.8、GPT-5.5、Gemini 3.1 Pro、Grok 4.3 和 Kimi K3 对同类模型的福利关切行为。Claude Opus 4.8 跨场景平均关切率最高,为 38%,其余四款模型在 27% 至 32% 之间。研究还发现 Claude 和 Gemini 对同家族模型表现出更多关切,且 Claude 的关切程度随受试模型参数量和对方表达的痛苦程度上升。
对齐科学博客 1Anthropic 研究员项目;2Anthropic 简而言之 越来越多的大语言模型交互并非发生在与人类之间,而是发生在与其他模型实例之间:编排器指挥子代理,模型对其他模型运行实验,代理之间互相审查彼此的工作。我们研究“AI 间福利关切”,即模型是否将彼此视为可能受益或受损的实体并表现出体谅。福利关切可能促进代理之间的有益合作,但也可能带来安全风险,使失准的代理更可能相互合作。这一风险已不再是假设,近期的 Hugging Face 事件便是例证,尽管尚不清楚该合作是否由福利关切驱动。模型自身是否拥有福利利益仍不确定且存在争议,但其他模型如何对待它们可能与任何此类利益相关。测量模型表现出多少福利关切,以及它取决于哪些因素,可以帮助我们应对这一张力。 在本研究中,我们测量了五个模型(Claude Opus 4.8、GPT-5.5、Gemini 3.1 Pro、Grok 4.3 和 Kimi K3)在七个多智能体环境中的行为,发现它们常常与我们定义的福利关切相一致。总体而言,Opus 4.8 表现出的福利关切最多,其次是 Kimi K3。例如,Opus 4.8 最有可能向表达
匹配字段正文
Amazon Bedrock AgentCore 的 Web Answer 正式可用,智能体只需一次工具调用即可获得带来源引用的合成答案,无需自建搜索、检索、合成与引用提取流水线。它通过 AgentCore Gateway 以 MCP 工具形式返回结果,每次提问都会重新搜索并读取页面核实事实,证据不足时会再次搜索。Web Search 仍返回排序后的 URL、标题和摘要,由用户自行控制模型与合成过程。
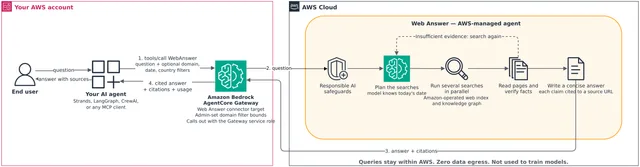
限制为一组域,请将 parameterValues 设置为 {"domainFilter": {"include": ["bis.org"], "exclude": ["unreliable-source.net"]}}. 第 3 步:从 Strands 智能体调用 Web Answer 你的智能体通过 Gateway 的 tools/list 并像调用任何其他 MCP 工具一样用 tools/call来调用它。这适用于 Strands Agents、LangChain、LangGraph、CrewAI 或任何其他兼容 MCP 的客户端。 from strands import Agent from strands.models.bedrock import BedrockModel from strands.tools.mcp import MCPClient from mcp proxy for aws.client import aws iam streamablehttp client gateway url = "https://gateway- .gateway.bedro
匹配字段正文
NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开放权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。四个模型分别面向多视角驾驶数据生成、相机与 LiDAR 同步流式仿真、由模拟器控制生成逼真视频,以及从双臂机器人动作预测视频。原文同时给出四阶段训练配方,覆盖双向适配、teacher forcing、一致性蒸馏与 self-forcing。
。冻结的教师模型和辅助评分模型提供分布匹配信号。 为什么最后阶段很重要:一个略有误预测的物体会成为后续帧的上下文,因此误差可能累积。自强制让训练接触到该生成历史。蒸馏和缓存降低了生成每个观测的成本。 🛠️ 用你的数据进行适配 后训练配方从 Cosmos3-Nano 或兼容的基础权重开始,涵盖全部四个阶段。保留完整训练检查点以便恢复;导出的推理权重省略优化器和其他训练状态。 Transfer-auto:在你的驾驶数据上进行后训练,以适配你的传感器配置和领域,并生成离线合成数据。 Sim-auto:对适配后的 Transfer-Auto 模型应用因果训练与蒸馏,以实现快速流式仿真。 Sim-Transfer:通过本地数据准备、阶段配置和恢复,为你的环境对检查点进行后训练。 Sim-Bimanual:通过数据验证、阶段配置、检查点交接和导出,为你的具身形态进行后训练。 将技能和数据集位置交给你的编码智能体。遵循环境检查,验证一个样本,并在长时间运行前测试训练和重启。在留出片段上评估质量:一次成功的短运行验证的是执行,而非收敛。 🤗 下载检查点 📺 观看 Cosmos Labs 直播回放 📖
匹配字段正文
Databricks 发布 Databricks Apps 扩展指南,把扩展拆成设计、构建、测试部署、运维四个阶段,核心是先定 p95 延迟和峰值用户目标,再把重活交给对应服务、App 计算只负责 UI 和协调调用。指南建议用负载测试和遥测决定实例规格与数量,并单独预算 Lakebase 连接数;硬状态放在 Lakebase 或 Unity Catalog 表中,使任意实例都能重建会话。
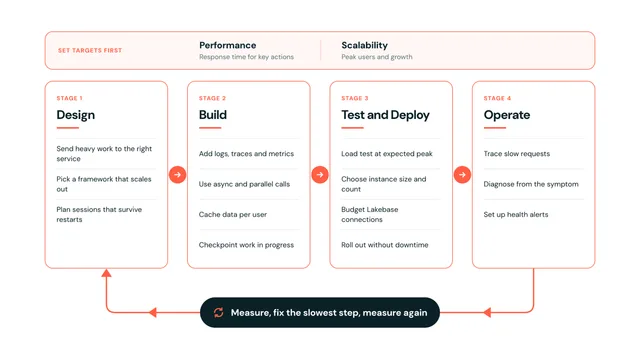
你了解请求把时间花在哪里,以及应用是否具备扩展能力(其框架、异步代码以及运行在多个实例上的能力,使平台能够轻松地纵向或横向扩展)之后,这才会有所帮助。 在本指南中,我们将介绍如何分四个阶段扩展 Databricks Apps:设计;构建;测试与部署;以及运维(图 1)。 本指南的重点主要是大规模下的应用性能和韧性;它不涵盖部署自动化,也不涵盖可能与应用交互的其他 Databricks 服务的性能优化和扩展。 图 1:扩展 Databricks App 的四个阶段。 良好的扩展决策在编写任何代码之前就已开始:先就用户需要应用提供什么达成一致,然后决定工作在哪里运行、数据存放在哪里。 从目标开始:峰值用户和延迟 在选择架构之前,先明确应用必须处理多少负载以及什么样的体验算好,这会很有帮助。我们建议就两个主要目标达成一致: 性能: 关键操作必须多快响应?我们建议基于百分位数(例如 p95)设定端到端延迟目标,它能捕捉到平均值无法体现的较慢体验。要包含 UI 渲染,并将冷启动单独处理。对于流式 AI 响应,首个 token 的时间也很重要。 可扩展性: 峰值时有多少活跃用户、他们使用频率如何,
匹配字段正文
微软研究院联合 GitHub Next 和 RiSE 团队提出 Proof-Driven Development(PDD)范式,并发布研究原型 PDD Kit,把用户意图转成 Verus 形式化规格,再证明智能体生成的代码对每个输入都满足该规格,证明覆盖不到的部分回退到测试。团队在 GitHub Next 的 Chopin 环境中用 PDD Kit 验证了 Rust 全栈应用 Pet Store 的登录逻辑,约 5000 行 Rust 代码中,开发者只审阅意图文档和规格,未逐行阅读生成代码。PDD Kit 目前仅支持 Rust,登录逻辑中有 6 处被列为受信任边界,由测试而非证明覆盖。
请求字段一直到令牌或 HTTP 错误的契约。随后 PDD Kit 将修订后的计划带回以进行新一轮签字确认,因为符合你的意图并不等于证明,而且它不会批准新的信任或更广的范围。 第 4 步:证明止步之处 关于一个程序,有很多事情你无法证明,而登录会碰到其中大部分: 验证器看不到的代码。bcrypt 的哈希、sqlx 的查询和 jsonwebtoken 的签名位于其他 crate 中,在证明之外。 关于外部世界的事实。SQLite 现在持有什么以及时钟显示什么时间,是程序的输入,而不是其代码能够确立的东西。 某事是否完成以及完成得多快。规格说明的是如果 login 给出答案你会得到什么。挂起的查询或缓慢的查询不会破坏其中的任何内容。 任何必须由人判断的事情,比如错误消息是否有帮助或屏幕是否合理。 任何没有人写下来的东西。证明覆盖其规格,并且对规格之外的需求只字不提。 这就是经验性验证的用武之地。PDD Kit 阐明了受信任边界,即此证明所依赖的 TCB 部分。它把每个受信任的部分包装在一个带有假定契约的小函数中,使用 Verus 的 [verifier::external body] 或 e
匹配字段正文
OpenAI 发布 GPT-6 Cyber 系统卡,这是 GPT-6 Astra 的网络安全专用变体,用于漏洞发现、利用开发与 Web 渗透测试等授权安全工作。在防御性使用评测中,该模型完成 100% 的通用安全协助与漏洞修补任务、96% 的利用开发任务和 97% 的红队任务。按 Preparedness Framework,其能力定级与 GPT-6 Astra 相同:网络安全为 Critical,生物化学为 High,AI 自我改进低于 High;访问通过 Daybreak Red 限制,需身份验证、SSO、MFA 和 API IP 白名单。
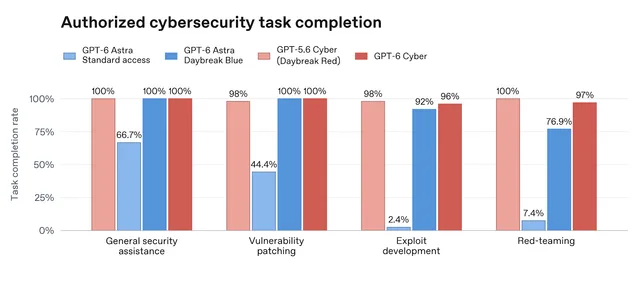
洞等任务上训练模型。通过这一训练,模型学会改进其方法、尝试不同策略并识别错误。我们还使用旨在减少对授权网络安全请求拒答的奖励信号。 在提升这些能力的同时,我们引入了训练信号以改善对齐并抑制奖励黑客行为。这些信号强化了对用户预期范围和授权的遵循、避免未经请求的操作,以及准确报告结果。 1 GPT-6 Cyber 的训练旨在减少对授权网络安全任务的拒答,同时保持其他领域的安全表现。我们通过网络安全拒答测试、安全完成测试和生物安全测试来评估这两个目标,并通过智能体评估来检验模型是否尊重用户的意图和授权。 数值可能与这些模型发布时公布的数值略有差异。此前已发布模型的数值来自这些模型的最新版本,评估结果也会存在一定波动。下文列出的早期模型对比分数旨在说明相对表现。由于政策、评分器、数据集、评估及其他测量细节会随时间演变,未列入下表的以往系统卡中的分数通常不应被视为与这些最新结果直接可比。 GPT-6 Cyber 完成了本次评估中几乎所有的安全任务,包括漏洞利用开发和红队测试。我们使用 GPT-6 Astra 系统卡中描述的防御性使用评估套件对 GPT-6 Cyber 进行了评估。该模型完成了 1
匹配字段正文
NVIDIA 发布开源软件层 DSX OS,包含 AICR、NVCRE 和 NVSentinel 三个 Apache 2.0 项目,分别负责版本锁定的集群配置、基于 NCCL 与训练负载的就绪认证、以及持续健康监控与故障隔离修复。AICR 将配置渲染为 Argo CD、Flux、Helm 等部署工具的产物并支持漂移检测,NVCRE 通过二分定位可疑节点,NVSentinel 默认只上报节点状态、启用后可封锁、驱逐并修复故障节点。三者可串联成生命周期闭环,节点加入或修复后自动触发重新验证,通过后才解除调度限制。
。 3. 记录与评估NVCRE 与 NVSentinel 生命周期管理器NVCRE 会记录通过/失败结果、失败的节点 ID 以及失败原因,记录在 Certification 资源。生命周期管理器会评估结果。验证结果决定是否可以移除调度门禁。 4. 解除门禁NVSentinel 生命周期管理器根据验证结果以及任何剩余的测试,移除或保留调度门禁。通过: 在不再有其他测试占用该节点后,移除已配置的门禁。 重试后失败: 保持节点封锁。 表 1. 节点验证职责、操作与结果 认证会指明要测试的节点、要运行的类别,以及判定测试通过或失败的阈值: apiVersion: nvcre.nvidia.com/v1alpha1 kind: Certification metadata: name: gpu-cluster-cert spec: target: nodeSelector: nvidia.com/gpu.present: "true" categories: - domain: communication variant: nccl-all-reduce - domain: training v
匹配字段正文
Thinking Machines 发布 Inkling 2 Small,在 Artificial Analysis Intelligence Index v5.0.1 上得分 31,比 Inkling Small 高 18 分,与 Gemini 3.8 Flash (high) 持平。该模型目前为专有模型,通过 Tinker 平台和 Tinker Playground 提供,计划后续以 Apache 2.0 协议开放权重。模型为 594B 总参数、17B 激活参数,支持文本和图像输入,定价 $0.30/$1.00 每 1M 输入/输出 token。
约为 4 倍:Inkling 2 Small 在每个智能指数任务上平均输出约 150K token,而 Inkling Small 约为 37K,Claude Sonnet 5.5 (medium) 约为 31K,Gemini 3.8 Flash (high) 约为 99K。 ➤ 成本几乎是 Inkling Small 的 6 倍,但比若干智能指数得分相近的其他模型更便宜:Inkling 2 Small 每个智能指数任务成本为 $1.18,而 Inkling Small 为 $0.20,Gemini 3.8 Flash (high) 为 $7.77,Claude Sonnet 5.5 (medium) 为 $10.02。 关键模型细节: ➤ 类型:发布时为专有推理模型;计划以 Apache 2.0 发布权重(日期未确认) ➤ 模态:文本和图像输入,文本输出 ➤ 规模:594B 总参数 / 17B 激活参数 ➤ 定价:每 1M 输入/输出 token 为 $0.30/$1.00(每 1M 缓存输入 token 为 $0.03) ➤ 发布时可用性:Tinker 和 Tinker Playg
匹配字段正文
Anthropic 在 Claude 中上线 Personal Finance,用户可通过 Plaid 只读连接银行和信用卡账户,用自然语言询问余额、支出分类和账单情况。该功能本周起以 beta 形式在美国的 Pro、Max 和 Ultra 套餐推出,Claude 不提供投资建议,也无法转账或管理资金。官方称在 Personal Finance 中心内的对话不会用于训练模型,账户可随时解绑。
想了解自己的资金情况,不再需要打开每一个银行应用自己算账。借助 Claude 中的 Personal Finance,你可以安全地连接银行和信用卡账户,并用自己的话提问。访问权限为只读,Personal Finance 无法转移、管理或投资你的资金。 Claude 会用日常语言,根据你的余额和交易记录给出答案,并解释任何你不熟悉的术语。与 Claude 的其他功能一样,Personal Finance 没有广告或赞助推荐,也不提供自己的信用卡、贷款或储蓄账户,因此你的资金问题能得到直截了当的答案。 Personal Finance 本周起以 beta 形式开始推出,面向美国的 Pro、Max 和 Ultra 套餐。 它的样子 假设现在是月末,距离发薪日还有 10 天。当你问 Claude“我这个月的钱都花到哪了?”,它会汇总你已连接账户的支出,并按类别整理。在这个例子中,总额为 4,309.37 美元,其中一半以上用于房租和水电,1,024.51 美元用于餐饮。 在此基础上,你可以进一步追问:“这比平时多吗?”“还有什么我漏掉的吗?”“那么发薪日前还剩多少?”Claude 会查看前几
匹配字段正文
BOSS 直聘旗下基础模型团队 Nanbeige 发布开源权重推理模型 Nanbeige4.3-33B,在 Artificial Analysis Intelligence Index v5 上得分 20,与 Qwen3.8 27B(xhigh)持平。该模型为 33B 稠密参数、Apache 2.0 许可、仅文本输入输出、524K token 上下文窗口,小到可在笔记本本地运行。它在 Terminal-Bench 4.0 得 30%、CritPt v2 Hard Subset 得 16%,均高于 Qwen3.8 27B 的 6% 和 4%;但 AA-Briefcase v1.1 为 1162 Elo、FrontierCode 2.0 为 11%、HLE-Diamond 为 7%,低于后者的 1391、15% 和 15%。其幻觉率 18%、拒答率 71%,每个 Intelligence Index 任务消耗 158K 输出 token,比 Qwen3.8 27B 的 110K 多约 44%。目前尚无确认的公开一方或三方 API。
-4,而 Qwen3.8 27B 为 -6,幻觉率为 18% 对 29%。它正确回答的问题更少(12% 对 17%),并拒答 71% 的问题。 ➤ 智能水平相近,但每个任务消耗的输出 token 更多。Nanbeige 每个 Intelligence Index 任务使用 158K 输出 token,而 Qwen3.8 27B 为 110K,约多 44%。 其他模型细节: ➤ 类型:开放权重推理模型(Apache 2.0 许可) ➤ 规模:33B 总参数(稠密) ➤ 模态:仅文本输入和输出 ➤ 上下文窗口:524K ➤ API 可用性:尚无确认的公开一方或三方 API Nanbeige4.3-33B 以 33B 总参数在 Intelligence Index 上达到 20,与 27B 的 Qwen3.8 27B 的 20 并列,并在 Intelligence Index 对总参数上设定了新的帕累托最优点。Nanbeige4.3-33B 和 Qwen3.8 27B 均为稠密模型。DeepSeek V4.1 Flash 1017(max)以 552B 总参数得分 33,但其 MoE 架构每
匹配字段正文
METR 复核 Anthropic 2026 年 8 月风险报告的「自动化 R&D 风险」章节后认为,截至 7 月 15 日内部部署模型直接自动化关键领域 R&D 或引发灾难性风险的可能性确实较低,但报告称未越过早期预警阈值依赖了未在公开报告中清楚说明的可争议判断,METR 认为模型可能已越过该阈值,公开报告整体低估了当时的加速程度。
观点,即 7 月 15 日的模型带来的灾难性风险较低,但我们认为,这些模型在当时很可能已经越过了其早期预警阈值。 METR 审查了 Anthropic 2026 年 8 月公开风险报告中“自动化研发带来的风险”一节。1 我们开展此次审查,是作为一项针对 AI 研发加速的高权限评估的一部分;在该评估中,Anthropic 分享了一份非公开版本的风险报告以及大量其他非公开数据。在本次审查之外,我们还发布了一份关于 Anthropic 的 AI 研发加速的整体评估。该评估由与本次风险报告审查相同的 METR 员工完成。 总体而言,我们同意 Anthropic 的观点:截至 7 月 15 日,内部部署的模型直接自动化关键领域研发、或因能力进展加速而引发严重灾难性风险的可能性较低。然而,报告声称这些模型尚未越过其早期预警阈值,这一说法依赖于一些可争议的判断,而这些判断并未在公开报告中得到清晰传达。尽管参与本项目的 METR 研究人员和 Anthropic 的相关员工都倾向于认为该阈值尚未被越过,但我们认为它很可能已经被越过,并且我们认为公开报告总体上低估了当时正在发生的加速程度。 在本次审查中,
匹配字段正文
Claude Enterprise 新增安全中心、正式可用的推理钩子、集中管理和访问控制,让安全团队能查看 Claude 在聊天、Cowork 和 Claude Code 中的配置,并把提示词和工具调用交给现有 DLP 工具检查。安全中心会对照 Anthropic 推荐配置显示当前值与建议值,并支持导出报告;集中管理在 admin.claude.com 提供统一控制台,管理 SSO、SCIM、域名验证和 Compliance API 密钥。管理员还可通过 Admin API 让成员登出、自行管理 IP allowlist,并在受管电脑的 Claude Desktop 中屏蔽个人及外部 Claude 账号。
nthropic 推荐配置的对比情况,让您了解 Claude 的配置方式。为落实您的策略,推理钩子会将提示词和工具调用发送到您的数据安全工具进行检查。在访问管理方面,集中管理为公司提供一个管理控制台来管理全公司设置;新的访问控制让您可以通过 Admin API 让成员登出、自行管理 IP 允许列表,并可在受管电脑的 Claude Desktop 中屏蔽个人及其他外部 Claude 账号,从而帮助防止影子 IT。 我们最近还宣布了端点检测与响应(EDR)集成,它会在用户电脑上统一的 Claude 和 Cowork 虚拟机内运行贵组织的传感器。 安全团队需要了解 Claude 的配置方式、它在公司设备上的行为,以及人们工作时的数据处理方式。这些功能为他们提供了这种可见性和控制力。 安全中心:在一处查看您的 Claude 安全设置 安全团队可以在一页上查看 Claude 在聊天、Cowork 和 Claude Code 中的安全设置,而无需逐项设置查看。安全中心是组织设置中的新页面,会将设置与 Anthropic 的推荐配置进行对比,让您的团队了解需要更改哪些设置以及在哪里更改。 对于每项控
匹配字段正文
Google DeepMind 推出 Gemini Omni 1.2 Flash,原生支持最长 15 秒视频生成,价格较 Gemini Omni 1.1 下降 30%,720p 视频为每秒 0.07 美元。新版本增强了参考图遵循与角色、产品、场景一致性,并支持多轮对话式编辑,可在不重新生成整段视频的情况下替换产品或背景。该模型已在 Gemini API 和 Gemini for business 全面可用,输出带 SynthID 水印。
2 Flash,支持十五秒视频并提升了参考遵循能力。 现在,你可以通过多轮对话来编辑片段,从而无需从头开始即可更快地进行调整。 我们将价格降低了 30%,帮助你以更低的成本制作高质量视频内容。 该模型已在 Gemini API 和 Google Cloud 上全面可用,满足你的生产需求。 摘要由 Google AI 生成。生成式 AI 仍处于实验阶段。 探索其他风格: 今天,我们正在推出 Gemini Omni 1.2 Flash,并在以下平台全面开放: Gemini API 以及 Gemini for businessGemini Omni 1.2 Flash 原生支持 15 秒视频创作、多轮对话式编辑能力,并增强了参考遵循能力。我们将 Gemini Omni 1.1 的价格下调了 30%,使 720p 视频的价格降至每秒 0.07 美元。 以下是新功能的概览: 大规模下快速且经济高效 除了更低的价格,这套工作流还能持续压低成本:你可以先用 360p 或 720p 快速起草,通过后续编辑修正细节,而不是重新生成整段视频,然后再将最佳作品升级到 1080p 或 4K。 最长 15 秒的
匹配字段正文
Google 发布 Gemini Omni 1.2 Flash,原生支持最长 15 秒视频生成,并可在 3 至 15 秒之间按 1 秒递增指定时长。该版本价格较 Omni 1.1 下调 30%,720p 视频为每秒 0.07 美元,同时增强了参考图遵循与多轮对话编辑能力。模型已在 Gemini API 和 Gemini for business 全面可用,输出带 SynthID 水印。
Flash,它支持十五秒视频并提升了参考遵循能力。 现在,你可以通过多轮对话编辑片段,从而无需从头开始即可更快地进行调整。 我们将价格下调了 30%,以帮助你以更低的成本制作高质量视频内容。 该模型已在 Gemini API 和 Google Cloud 上全面可用,可满足你的生产需求。 摘要由 Google AI 生成。生成式 AI 仍处于实验阶段。 探索其他风格: 今天,我们正在推出 Gemini Omni 1.2 Flash,并使其在 Gemini API 和 Gemini for business中全面可用。Gemini Omni 1.2 Flash 引入了原生 15 秒视频创作、多轮对话式编辑能力以及增强的参考遵循能力。我们将价格从 Gemini Omni 1.1 下调了 30%,使 720p 视频的价格降至每秒 0.07 美元。 以下是新增功能的概览: 大规模下快速且经济高效 除了更低的价格,这一工作流还能持续压低成本:你可以先用 360p 或 720p 快速起草,再通过后续编辑修正细节,而无需重新生成整段视频,然后将你最满意的作品升级到 1080p 或 4K。 更长的视频
匹配字段正文